Всем привет! По бэкграунду я инженер, и некоторое время назад решил запустить IT-проект — сервис для маркетплейсов. В этом блоге я планирую делиться реальным практическим опытом: от разработки до продаж. Буду рассказывать как про личный опыт, так и про опыт участников команды.
Эта статья — подробный технический разбор того, как проектировалась архитектура для расчета выручки для системы аналитики, на какие грабли наступали, почему классический теорвер и матстат из университетских учебников спотыкаются о сырые данные маркетплейсов и как в итоге удалось собрать архитектуру расчета продаж.
В статье не будет сырых простыней кода — только математика, архитектура, реальные проблемы на боевых данных и их решения.
Глава 1. Период наивности: Ozon, данные без истории и отзывы вместо продаж
Путь начинался с простой задачи: был массив данных с Ozon, сгруппированный по категориям. Данные представляли собой простой снимок текущего состояния карточек: название, текстовые характеристики, цена, рейтинг и число отзывов. Исторических данных не было в принципе. Не было временных рядов остатков, не было динамики цен. Ничего не было, только данные в один конкретный день. Но даже с таким набором можно работать.
Блочная архитектура анализа
Исходя из доступных данных и желаемого результата было решено разделить систему на модули:
1. Сегментация и поиск аномалий: выделение ценовых сегментов и составление топа товаров в каждом сегменте.
2. Анализ наименований: выявление слов-триггеров в заголовках карточек, коррелирующих с успехом товара.
3. Анализ структуры продавцов: оценка монополизации ниши через классические экономические метрики.
4. Оценка характеристик: легковесный ML.
Метрики концентрации: HHI и CR
Для оценки конкурентности мы использовали индекс Херфиндаля-Хиршмана (HHI) и коэффициент концентрации (CRₖ):
HHI = ∑ (sᵢ)²
где sᵢ — рыночная доля i-го продавца в процентах (0 ≤ sᵢ ≤ 100).
-
Если рынок поделен поровну между 100 продавцами, sᵢ = 1%, то:
HHI = 100 × 1² = 100 (высокая конкуренция) -
Если один монополист держит 70%, а остальные 30 делят остаток по 1%:
HHI = 70² + 30 × 1² = 4930 (жесткая монополия)
HHI родился как экономический инструмент для измерения концентрации, но его математическое ядро — мера неравномерности распределения долей. Поэтому он естественным образом переносится на любые задачи, где есть набор взаимно исключающих категорий и их доли. В нашем случае мы использовали HHI по сути как готовый инструмент и обратились к его историческому назначению — определению неравномерности долей.
К нему добавили CRₖ — кумулятивная доля k крупнейших игроков:
CRₖ = ∑ sᵢ для i от 1 до k
В чем была главная проблема?
Единственной доступной метрикой спроса выступало число отзывов (F).
Мы понимали, что отзывы — это прокси-метрика. Причем крайне инертная:
— Карточка, продающаяся 4 года, накопила 5 000 отзывов, но за последний месяц могла не сделать ни одной продажи.
— Новинка с быстрым взлетом имеет 15 отзывов и 2 000 заказов за неделю, но в аналитике по отзывам она выглядит как абсолютный аутсайдер.
В общем-то, даже так результаты нам показались удовлетворительными — бились со здравым смыслом, и для нас это было достаточным показателем качества. Тем более мы осознавали, что с ограниченным набором данных и отсутствием исторических данных не получится сделать что-то принципиально иное — данных просто недостаточно.
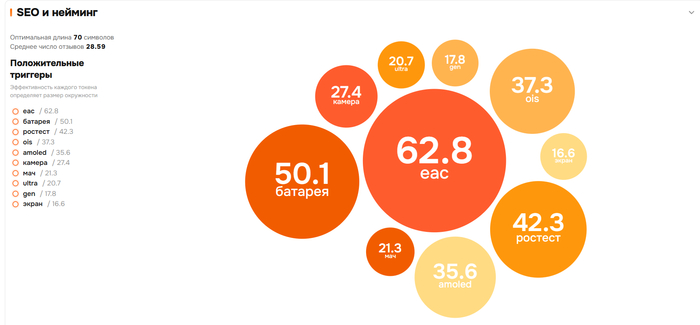
Пример результата аналитики для категории Смартфоны, который получился на данных без истории. По прокси-метрике отзывов настроили расчеты влияния тех или иных слов на спрос. Расчеты реализовали через токенизацию всех наименований.
Глава 2. «Теперь-то мы посчитаем всё точно!»: расчет продаж по складским остаткам и ценам Wildberries
В какой-то момент все-таки появились исторические данные, правда на WB. Ежедневные снимки складов и цен Wildberries — казалось, что святой Грааль найден. Больше никаких косвенных метрик! Из самого важного в распоряжении были данные:
-
product_id (SKU);
-
wh (идентификатор склада: Коледино, Электросталь, Казань и т.д.);
-
qty (физический остаток товара на складе);
-
price_product (история цен);
-
changed_at (временная метка фиксации).
Наивная модель восстановления продаж
Логика казалась железобетонной. Для каждого товара на складе строим временной ряд остатков Sₜ.
Изменение остатка между соседними днями t — 1 и t:
ΔSₜ = Sₜ − Sₜ₋₁
Интерпретация:
-
Если ΔSₜ < 0 — это продажа:
Salesₜ = −ΔSₜ -
Если ΔSₜ > 0 — это поставка:
Supplyₜ = ΔSₜ -
Если ΔSₜ = 0 — движения не было.
Казалось бы, просуммируй Salesₜ × Priceₜ по всем складам и дням — получишь выручку ниши или товара. Мы написали код агрегации, запустили расчет и… на выходе получили абсолютный бред.
Глава 3. Жестокое столкновение с реальностью: Почему дельта остатков дает сбой.
Первые же тесты на реальных категориях указали нам наше место.
Проблема №1: Дырчатый календарь и фантомные нули
Получить данные с миллионов карточек — процесс вероятностный:
— Бывают дни, когда данные просто отсутствуют (по техническим или иным причинам просто нет данных за этот день/промежуток).
— Бывают дни, когда конкретный артикул просто не вернулся в поисковой выдаче. Например, если товар закончился или временно скрыт.
Если 26-го числа у товара было 3 единицы, 27-го данные отсутствуют, а 28-го товара нет в выдаче — это 0 остатков или, может, продавец сменил фото карточки и товар ушел на модерацию?
Если считать отсутствие данных за 0, то:
1. День 1: остаток 3.
2. День 2: остаток 0 → записываем 3 продажи.
3. День 3: товар вернулся, остаток 3 → записываем поставку 3.
4. День 4: товар снова мигнул в выдаче → снова 3 продажи.
В итоге товар, лежащий мертвым грузом, «генерировал» продажи каждые два дня.
Проблема №2: «Синдром дачника»
На маркетплейсах тысячи селлеров работают по системе FBS (продажи со своего склада).
Представьте типичного продавца:
— У него карточка с 2 отзывами.
— На складе числится 50 чехлов для телефонов. Продаж нет неделями.
— В пятницу днем продавец решает уехать на выходные на дачу. Чтобы в субботу не упал заказ, который он не сможет вовремя упаковать (иначе WB влепит штраф за срыв логистики), он заходит в личный кабинет и руками выставляет остаток `0`.
— В понедельник он возвращается и выставляет остаток обратно: `50`.
Что видит наивный расчет?
— Пятница: остаток упал с 50 до 0 (ΔS = −50). Продано 50 штук!
— При цене чехла 800 рублей алгоритм рисует карточке с 2 отзывами 40 000 рублей выручки за день.
— Модуль аналитики моментально поднимает этот мусорный товар, искажая всю статистику категории, так как это место мог занять реально продающийся товар.
Мы назвали эту проблему «Синдром дачника» — конечно, не факт, что товар просто убирается руками и потому его остатки на складах скачут. Но в дальнейшем станет понятно, что нам в принципе и не нужно искать причину таких скачков.
Проблема №3: Загадочный график «трех пиков»
Мы открыли детальный отчет по категории аксессуаров для волос (реальный артикул из наших логов: «Крабики для волос маленькие», цена 181 руб., 1 858 отзывов, расчетная выручка 28 683 руб.).
Вот как выглядел график выручки по дням:

Такой график получился, видно, что это просто три выброса — товар не может продаваться по 50 штук трижды, а в остальное время иметь ноль продаж.
-
Три дня (11, 16 и 19 июля) показывают всплески ровно по 9 000 – 9 500 рублей (~50–54 штуки проданных крабиков).
-
Во все остальные 27 дней месяца выручка — строгий ноль.
Почему живой товар с 1 800 отзывами продается строго три раза в месяц пачками по 50 штук, а между ними пустота? В этот момент стало ясно: мы моделируем не поведение покупателей, а какую-то техническую неточность.
Глава 4. Битва с ветряными мельницами: Почему сломался математический аппарат
Мы обратились к математике. У нас была возможность обратиться к человеку с сильным математическим бэкграундом, и первой мыслью было: «Сейчас мы почистим данные нормальными статистическими фильтрами и все будет в масле».
Мы сели проверять гипотезы:
Распределение Стьюдента и 3σ (трехсигмовые интервалы)
Мы пытались считать скользящее среднее и стандартное отклонение по продажам или остаткам и отрезать всё, что вылетает за доверительный интервал [μ − 3σ, μ + 3σ].
Почему развалилось:
1. Данные продаж на маркетплейсах не имеют нормального распределения.
Мы вообще в принципе не знаем, какое точно у нас распределение — оно сильно зависит от категории, а также от фильтров, которые мы выставим на набор данных. В ВУЗе мы обычно использовали статистику, имея некоторые допущения, гипотезы, предположения. От этого можно было оттолкнуться. А как определить в случае, когда мы не знаем распределение, верно ли мы применяем алгоритмы?
2. Экстремальные масштабы.
Всплеск продаж в день акции или после захода с рекламой может превышать среднее на 2–3 порядка. Если вы отсекаете по 2σ или 3σ, вы срезаете реальных лидеров рынка, но при этом пропускаете систематические выбросы у мелких товаров.
3. Проблема уровня агрегации (товар vs рынок).
-
Если проверять выбросы внутри одного товара, то у товара-пустышки дроп с 50 до 0 — это единственное событие, у него выборочная дисперсия равна нулю. Такой алгоритм не считает это выбросом.
-
А если проверять по всему рынку, то продажа 50 крабиков — обычное дело для крупного оптовика, но невозможная аномалия для селлера с нулевым рейтингом.
Переход к устойчивой (робастной) статистике: Log-IQR
Мы отказались от среднего и дисперсии в пользу медиан и квантильных размахов в логарифмическом пространстве.
Мы полагаем, что распределение цен и выручки мультипликативно, потому перевели метрики в логарифмическую шкалу:
y = ln(x + 1)
Затем считали интерквартильный размах ($IQR$):
IQR = Q₃ − Q₁
Верхняя граница отсечения выбросов:
Threshold_upper = Q₃ + k · IQR
Для цен в rule-based сегментации мы взяли мягкий коэффициент, а для кластеризации на основе нейросетей — более строгий. Здесь не так важно точное значение коэффициента, так как оно подбирается экспериментально.
Создание централизованного фильтра: Revenue Quality Filter
Чтобы остановить поток фантомной выручки, мы спроектировали трехуровневый алгоритм верификации качества. Алгоритм не удаляет товар из выборки, но помечает его флагом артефакта (is_artifact = True) и обнуляет расчетную выручку и продажи.

Блок-схема расчетов
Математика трех правил:
1. Правило 1 (Глобальный экстремум):
Отсекает технические выбросы данных, когда товару приписывалась выручка в сотни миллионов или миллиарды рублей.
2. Правило 2 (Аномальная выручка на один отзыв):
Для товаров из нижнего 5%-хвоста по отзывам (F ≤ Q₀.₀₅(F)) рассчитывается показатель удельной выручки:
R_unit = Revenue / (F + 1)
Если R_unit превышает квантильный порог референсной группы рынка (товары с F > Q₀.₀₅(F)), товар помечается флагом артефакта.
3. Правило 3 (Фантомные новички):
Если у товара 0 отзывов (F = 0), а его выручка превышает 5 медианных выручек зрелых товаров в своем ценовом бине:
Revenue > 5 · Median(Revenue_mature)
он признается артефактом.
Шок от реальных данных: десятки миллионов мусорных рублей
Когда мы прогнали этот фильтр на реальных выгрузках, результат все еще был далеко от идеала. Вот пример реального расчета:
Пример 1: Категория «Кинетический песок»
-
Всего проанализировано товаров: 1 581 SKU
-
Количество товаров, признанных артефактами: 742 SKU (почти 47% товаров из выборки!)
-
Сырая выручка, рассчитанная по дельте остатков: 59 818 625 руб.
-
Очищенная выручка после фильтра: 2 890 246 руб.
-
Срезано выручки: 56 928 379 руб. (95.2% расчетной выручки было мусором!**)
Вывод: 741 товар имел 0 отзывов, но алгоритм дельты нарисовал им 56 миллионов несуществующих продаж!
Пример 2: Категория «Аксессуары для волос»
-
Всего проанализировано товаров: 74 127 SKU
-
Товаров-артефактов: 5 710 SKU
-
Сырая выручка: 2 917 609 966 руб. (2.91 млрд руб.)
-
Очищенная выручка: 2 172 959 466 руб.
-
Срезано фантомной выручки: 744 650 500 руб. (почти три четверти миллиарда рублей мусора!)
Фильтр спасал от бреда, но оставалось чувство неудовлетворенности: мы просто зануляли половину рынка. Неужели нельзя восстановить истину?
Глава 5. Байесовское сглаживание: Приручение шума
Параллельно мы искали математический способ не бинарно вырезать товары, а плавно штрафовать метрики за недостаток данных.
Байесовское сглаживание в модуле Нейминга
В модуле текстового анализа названий наивное среднее тоже приводило к абсурду, хотя и не так часто: редкое слово (например, «экстра-супер-увлажнение»), встретившееся ровно 1 раз у товара-лидера, получало среднюю выручку в 500 000 рублей и вылетало на 1-е место рейтинга эффективности.
Мы применили формулу байесовского сглаживания с псевдонаблюдениями:
μ̂ᵢ = (C · m + ∑_{j=1}^{nᵢ} xᵢⱼ) / (C + nᵢ)
где:
-
∑ xᵢⱼ — сумма метрики (выручки или отзывов) товаров, содержащих n-грамму i;
-
nᵢ — реальное число вхождений фразы;
-
m — глобальное среднее по всему рынку;
-
C — статистический вес эмпирических данных (число псевдонаблюдений).

Если слово встретилось 3 раза, его оценка на 98.5% определяется рыночным фоном, и лишь при сотнях повторений слово завоевывает право называться драйвером продаж.
Не думаю, что про Байесовское сглаживание стоит подробно рассказывать. Это достаточно популярная вещь — можно найти много информации в интернете. Например, отличная статья.
Внедрение внутреннего индекса доверия
Мы решили адаптировать этот принцип к выручке товаров. Вместо жесткого отсечения мы ввели внутренний весовой коэффициент доверия к выручке на основе отзывов:
W(F) = W_min + (1 − W_min) · min(1, F / Q₇₅(F))
где:
-
W_min — минимальный вес доверия (0 < W_min < 1);
-
F — количество отзывов карточки;
-
Q₇₅(F) — 75-й перцентиль отзывов по рынку.
Внутренняя метрика использовалась для ранжирования карточек в выдаче, не позволяя товарам без валидации на основе данных группы пробиваться в топы.
Но оставался главный нерешенный вопрос: откуда всё-таки брались те загадочные пачки продаж по 44, 50, 53 штуки?
Глава 6. Момент истины: Секрет, который обнулил все расчеты по остаткам (как кэп остатков ломает аналитику)
Аналитика по дельте остатков системно дает сбой, поскольку интерфейс Wildberries кэпирует остатки в корзине, превращая колебания лимита в ложные продажи.
Конец июля 2026 года. Очередная ночная сессия дебага логов и поиска закономерностей.
Мы взяли один из тестовых аккаунтов селлера, загрузили на склад 100 единиц товара и открыли карточку в браузере как обычный покупатель. Нажали «Добавить в корзину» и попробовали выкрутить счетчик количества на максимум.
И тут наступил шок: Wildberries кэпирует остатки на витрине!
Оказалось, что интерфейс корзины Wildberries не показывает реальный остаток товара на складе, если он превышает определенный лимит. На витрине отдается искусственно обрезанное число. Оно колеблется в динамическом диапазоне (например, от 40 до 60 штук).
Более того, это значение может динамически меняться в зависимости от геолокации, типа склада, сессии пользователя или иных параметров.
Что это значило для нашего пайплайна?
Представьте:
1. У продавца на складе лежит 5 000 единиц товара.
2. Попытка узнать остатки: qty = 54 (сработал витринный кэп).
3. На следующий день стучимся на витрину снова, но получаем другой лимит: qty = 44.
4. Наш алгоритм делает расчет: ΔS = 44 — 54 = -10. Зафиксировано 10 продаж!
5. На третий день получаем qty = 53. Алгоритм видит увеличение остатка ⟹ считает это поставкой.
6. На четвертый день карточка на секунду выпала из выдачи: qty = 0. Алгоритм радостно пишет: продано 53 штуки!
Мы неделями искали идеальные формулы математической статистики, чтобы победить шум, который не являлся шумом на самом деле.
Считать продажи вычитанием складских остатков на Wildberries — это попытка измерить глубину линейкой, длина которой произвольно меняется.
Глава 7. Архитектурный разворот: Как считать продажи, если остаткам верить нельзя
Осознав природу данных, мы совершили фундаментальный разворот в архитектуре.
Мы вернулись к отзывам, но не в их примитивном виде, а через иерархическую систему калибровки продаж продавца.

Блок-схема расчета выручки через отзывы
В чем суть нового подхода?
Есть не только данные по товарам, но и периодические снимки по продавцам в целом:
-
sold_products_count — общее число заказов / проданных товаров всего магазина селлера;
-
product_feedbacks_count — суммарное число отзывов на всех товарах селлера.
За любой интервал времени для продавца известны два фундаментальных макро-показателя:
-
Сколько реально продал весь магазин: ΔS_seller;
-
Сколько реально новых отзывов получил весь магазин: ΔF_seller.
Это дает нам фактическую эмпирическую конверсию отзывов в заказы именно для этого продавца в этот конкретный календарный период:
K = ΔS_seller / ΔF_seller
При расчете выручки через отзывы есть тоже свои нюансы. Не должно быть никаких догадок из серии «на WB один отзыв приходится в среднем на 30–50 покупок». Такие догадки никуда не годятся. Для бренда дешевых носков этот коэффициент может быть равен 80, а для премиальной бытовой техники — 12.
Спуск на уровень товара
Когда у конкретного товара i, принадлежащего данному продавцу, за интервал времени вырастает число отзывов на ΔF_i, его доля в общем пуле продаж магазина определяется пропорцией прироста его отзывов к общему приросту отзывов селлера:
Raw_Sales_i = ΔS_seller · (ΔF_i / ΔF_seller) = K · ΔF_i
Целочисленное квантование: Метод Гамильтона
Поскольку Raw_Sales_i получается дробным числом, а товар измеряется в целых штуках, мы применили классический метод распределения мест Гамильтона (метод наибольших остатков, allocate_integer_sales):
-
Каждому товару с положительным приростом отзывов гарантированно отдается целая часть (но не менее 1 шт):
Base_Sales_i = ⌊Raw_Sales_i⌋ -
Оставшийся нераспределенный пул заказов:
R = ΔS_seller − ∑ᵢ Base_Sales_i
поочередно раздается товарам с максимальной дробной частью
Raw_Sales_i − ⌊Raw_Sales_i⌋
Консервативная привязка цен
Чтобы исключить раздувание выручки, если продавец кратковременно менял цену (например, задрал перед акцией), мы сопоставляем интервал продажи с историей изменения цен:
Price_calc = min_{t ∈ T} (Price_t)
Берется консервативный минимум цены за интервал наблюдения.
Результат архитектурного перехода
-
Исчезли фантомные миллионы: товары с 0 отзывов физически больше не могут получить ни единой продажи из-за скачков складских лимитов.
-
Ушел эффект кэпирования корзины: алгоритм вообще не смотрит на остаток товара, если тот подвержен витринным ограничениям.
-
Сохранилась адекватная динамика: если селлер запустил рекламу и пошли продажи с отзывами, они пропорционально и честно распределяются между его SKU.

Вот так стал выглядеть график продаж через данные об отзывах по товару из категории Зоотовары / Для собак / Ветаптека. К тому же, лидеры рынка стали определяться корректно.
Глава 8. Чек-лист по расчету аналитики маркетплейсов
Сравнительный анализ методов расчета продаж

Чек-лист: Как построить надежный пайплайн e-commerce аналитики
1. Никогда не доверяйте исходным числам:
Витринные значения могут быть срезаны кэпами, кэшем или поведением корзины.
2. Забудьте про стандартные распределения:
Никаких нормальных кривых и 3σ. Используйте только непараметрические и робастные статистики: квантили (Q_p), межквартильный размах (IQR), медианы и логарифмирование (ln(x + 1)).
3. Внедряйте многоуровневую верификацию артефактов и выбросов:
Если ваш алгоритм насчитал товару с 0 отзывов миллион рублей выручки — в 99.9% случаев неправ ваш алгоритм, а не покупатели смели склад.
4. Используйте байесовское сглаживание — оно реально работает:
Редкие события должны притягиваться к среднему по рынку. Для текстовых признаков (нейминг, теги) и для метрик надежности используйте фиктивные псевдонаблюдения.
5. Связывайте микро-уровень с макро-уровнем:
Если метрика на микро-уровне дает сомнительный сигнал, проверяйте и калибруйте ее через родительскую сущность (магазин, категорию, бренд).
Заключение: Почему ни один внешний сервис не знает 100% правды
Если вам в рекламе очередного сервиса аналитики заявляют: «Мы знаем точные продажи каждого товара на Wildberries с точностью до одной копейки по нашим секретным данным» — теперь вы знаете, что эти секретные данные могут оказаться не очень верными.
Внешняя аналитика маркетплейсов — это не про точность до рубля, из открытых источников такое достать невозможно. Это про понимание структуры рынка, поиск реальных закономерностей и отсечение информационного мусора.
Когда мы перестали пытаться выжать из дырявых складских остатков несуществующую точность и построили математически выверенную модель, хоть и не дающую точность до рубля, система наконец начала выдавать отчеты, на которые можно опереться при принятии реальных бизнес-решений.
Внешняя аналитика — это всегда вероятностная модель и баланс компромиссов.
А как вы боретесь с выбросами и аномалиями в данных и какими средствами аналитики пользуетесь? Делитесь в комментариях своим опытом — будет интересно обсудить!
Какие темы на пути к построению своего IT-проекта было бы интересно увидеть в следующих постах?
Проверить достоверность описанной методики и оценить результат проделанной работы можно в инструменте аналитики моего проекта.